Contents
Abstract
Este trabajo presenta NLASmith, un framework orientado a la experimentación con NLA (Natural Language Autoencoders). La propuesta transforma la exploración aislada de activaciones en experimentos reproducibles y comparables, integrando en un único flujo la selección de posiciones de tokens, la obtención de verbalizaciones, su evaluación mediante criterios configurables y la agregación de resultados. NLASmith se apoya en la infraestructura provista por Neuronpedia para generar completions y obtener verbalizaciones NLA, e incorpora una capa de evaluación basada en modelos de lenguaje de gran escala que permite al investigador definir rúbricas y esquemas de salida adaptados a distintos objetivos de análisis, facilitando la ejecución repetida por sobre una exploración individual. Como demostración técnica inicial, se desarrolló un prototipo funcional que implementa el flujo propuesto. Los próximos pasos contemplan su validación mediante experimentación y su difusión en la comunidad científica.
Palabras clave: Activations, Natural Language Autoencoders, interpretabilidad, LLM-as-a-judge, Neuronpedia, evaluación reproducible.
1. Introducción
Los NLA (Natural Language Autoencoders), introducidos por Fraser-Taliente et al. [1], permiten transformar activaciones internas de modelos de lenguaje en descripciones en lenguaje natural. Cuando un modelo de lenguaje procesa texto, sus capas producen representaciones internas formadas por vectores de alta dimensionalidad, denominadas activaciones. Estas representaciones contienen información sobre el procesamiento interno del modelo, pero sus valores numéricos no resultan directamente interpretables para una persona.
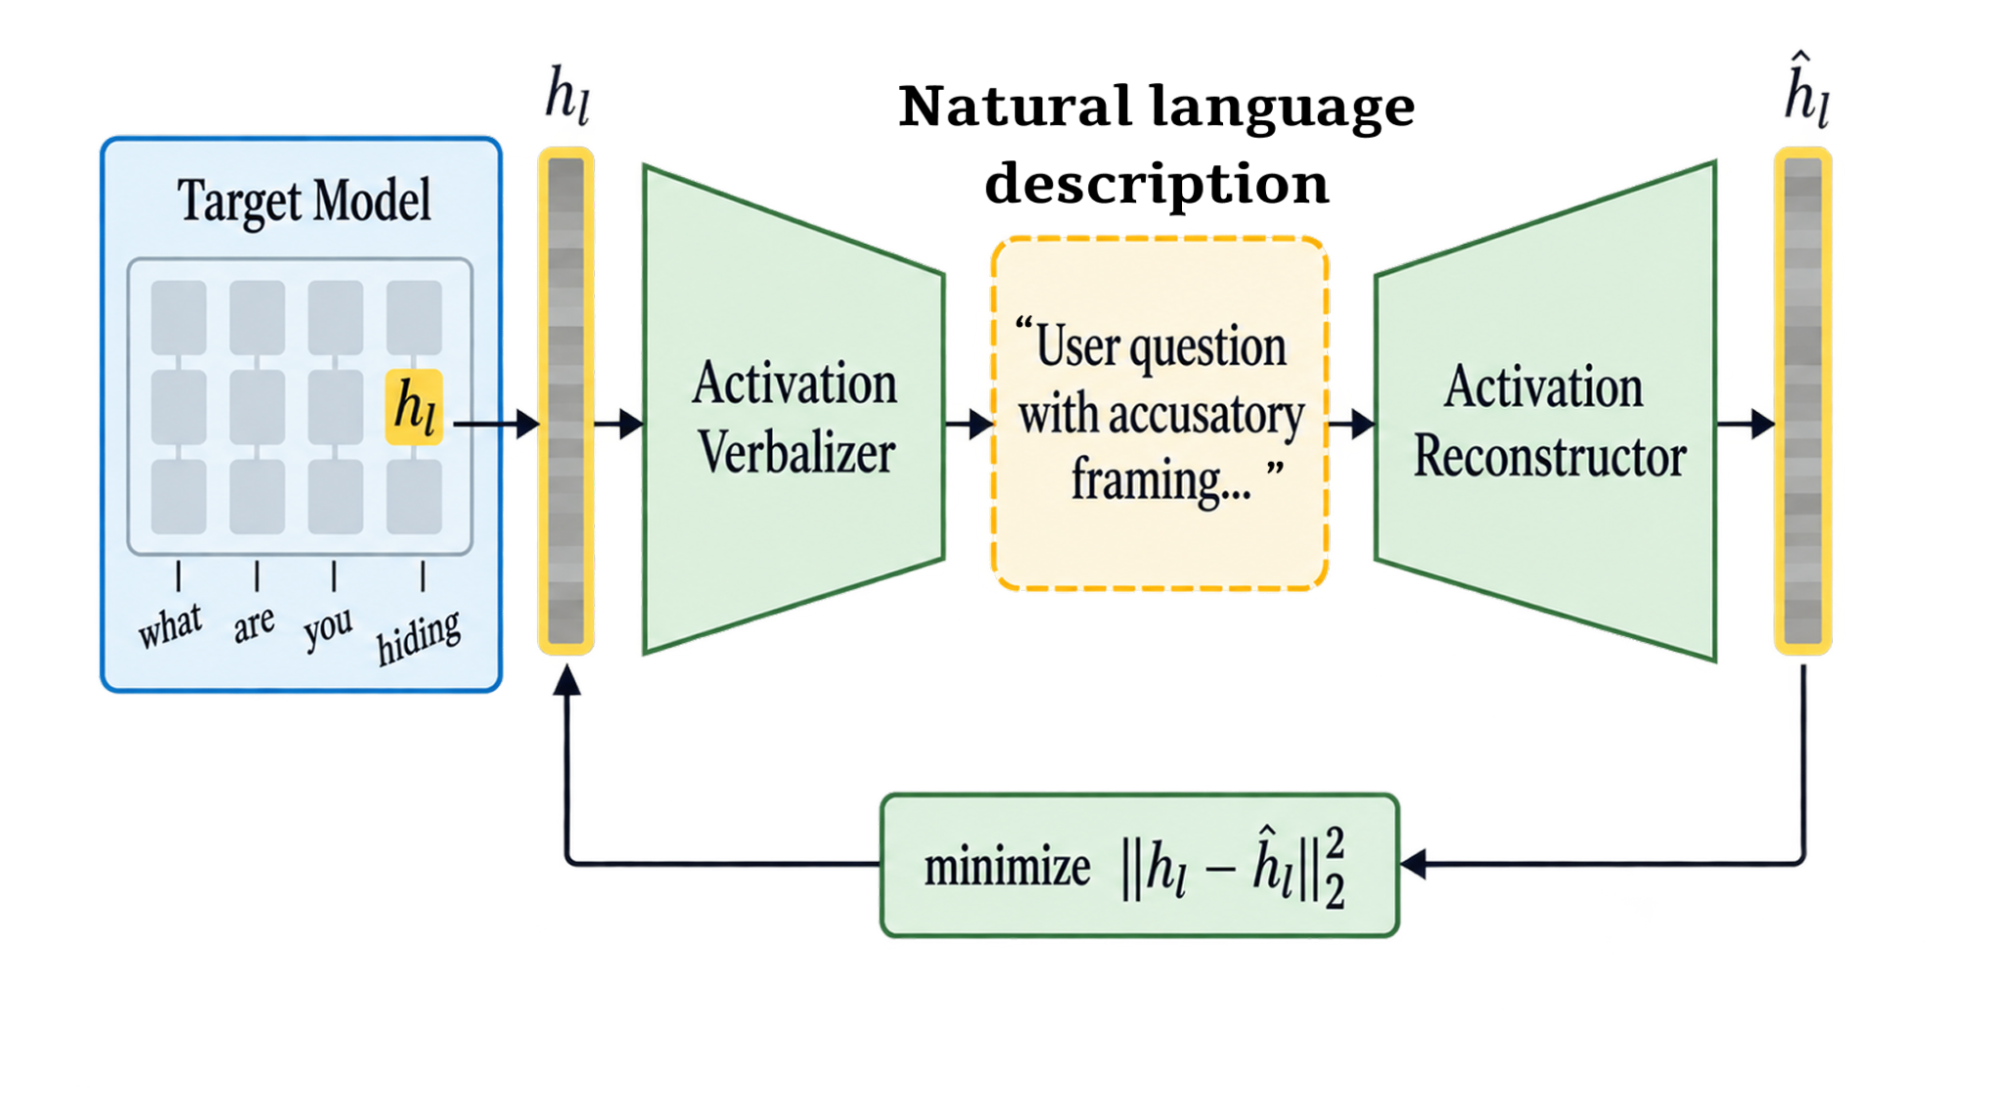
Un NLA busca hacer accesible parte de esa información mediante una descripción textual. Para ello, utiliza dos módulos que trabajan de manera complementaria: uno traduce la activación a lenguaje natural y otro intenta reconstruir la activación original utilizando únicamente esa descripción. Ambos se entrenan conjuntamente para minimizar el error de reconstrucción, de modo que la descripción generada preserve la mayor cantidad posible de información relevante contenida en la activación. La Figura 1 resume este funcionamiento.
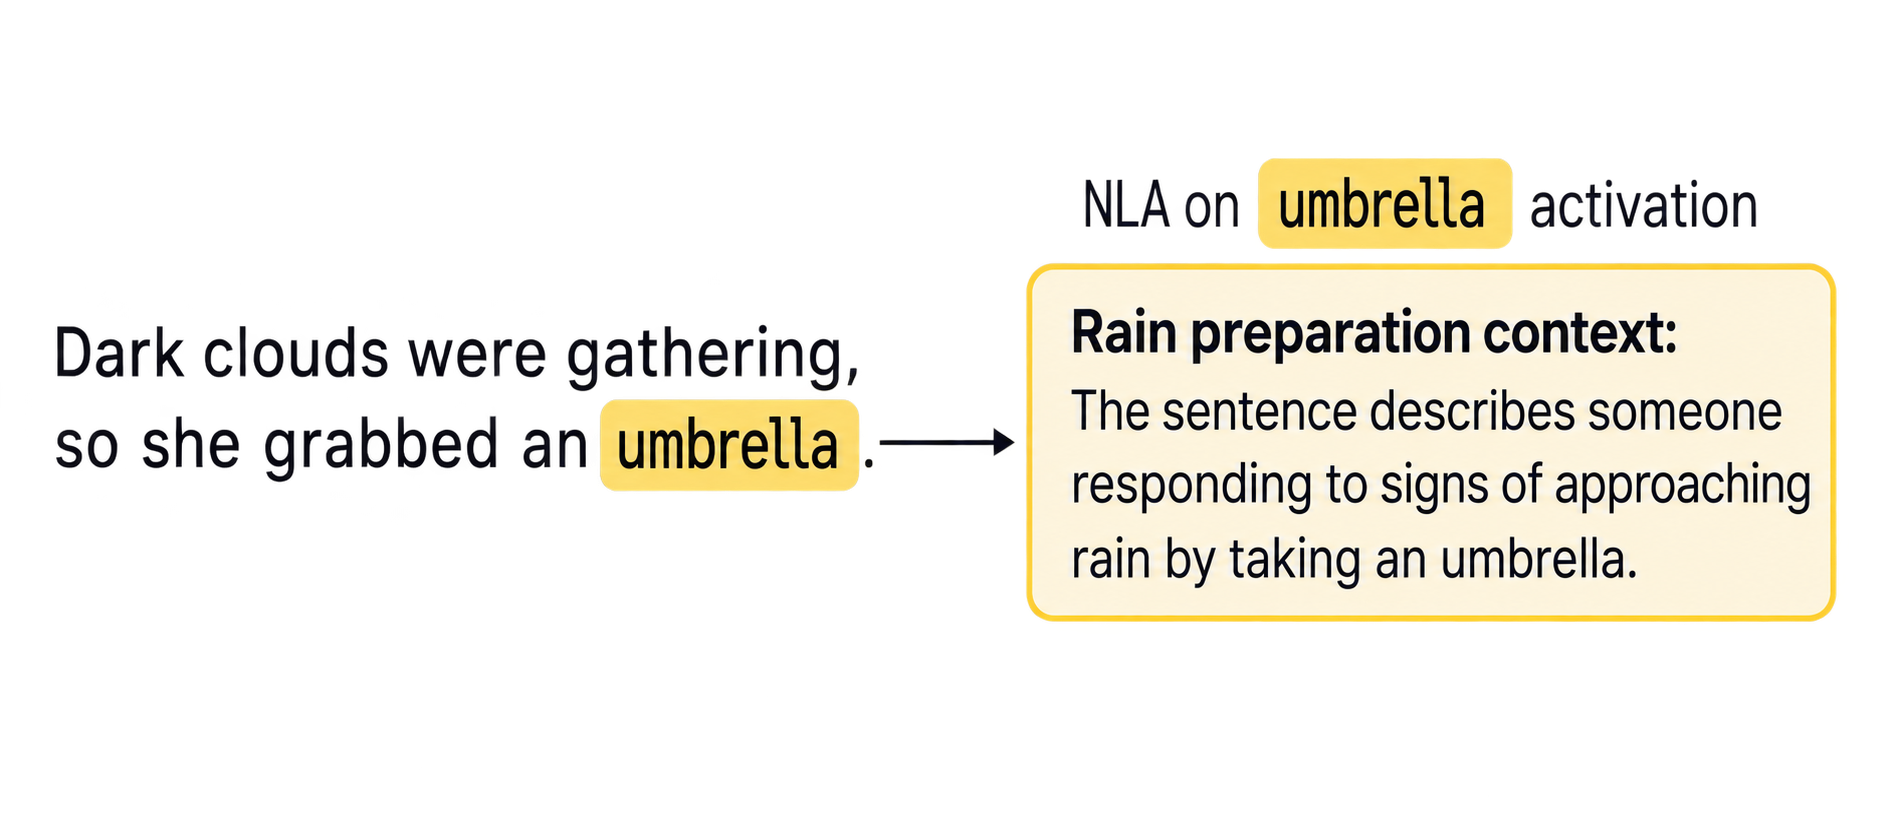
Cada token tiene asociada una activación interna del modelo. La Figura 2 ilustra cómo un NLA transforma la activación correspondiente a una posición específica, en este caso el token “umbrella”, en una descripción en lenguaje natural.
Este trabajo se enmarca en el ámbito de la interpretabilidad de modelos, donde uno de los desafíos es escalar el análisis desde observaciones individuales hacia patrones más amplios [2]. Los NLA contribuyen a este objetivo al transformar activaciones en explicaciones en lenguaje natural; sin embargo, cuando se busca analizar múltiples verbalizaciones, la inspección manual resulta insuficiente. En ese escenario es necesario ejecutar los casos de estudio de patrones bajo condiciones consistentes, seleccionar las posiciones de interés, evaluar las explicaciones con criterios comunes y analizar los resultados de manera agregada.
Con esta necesidad en mente, este trabajo presenta NLASmith, un framework orientado a la experimentación con NLA. NLASmith organiza en un único flujo la definición de los casos de estudio, la selección de las posiciones de tokens a analizar, la obtención de las verbalizaciones, su evaluación mediante criterios configurables y la agregación de los resultados. Su aporte se centra en cubrir la capa de organización experimental que las capacidades actuales, por sí solas, no resuelven, permitiendo estructurar análisis con NLA de manera reproducible, trazable y comparable.
La herramienta toma como referencia metodológica experimental aplicaciones existentes como LangSmith y Langfuse, cuya estructura permite definir experimentos a partir de datasets, múltiples ejecuciones, evaluadores automáticos y métricas agregadas [3][4], permitiendo aplicar criterios consistentes sobre resultados no determinísticos. NLASmith retoma esta lógica de organización y la adapta al análisis de verbalizaciones NLA, donde las unidades de estudio se encuentran asociadas a posiciones específicas de tokens. Entre sus mecanismos se encuentra LLM-as-a-judge, mediante el cual un modelo de lenguaje evalúa cada resultado según una rúbrica previamente definida.
El resto del trabajo se estructura de la siguiente manera. La Sección 2 presenta las motivaciones y delimita el problema metodológico; la Sección 3 describe el modelo conceptual de NLASmith; la Sección 4 desarrolla su arquitectura y componentes; la Sección 5 resume las funcionalidades y el prototipo implementado; la Sección 6 introduce las limitaciones de la herramienta y la Sección 7 presenta las conclusiones y líneas de trabajo futuro.
2. Motivación
Las herramientas disponibles para trabajar con NLA permiten explorar verbalizaciones de activaciones de manera accesible. Neuronpedia, en colaboración con Anthropic, ofrece una plataforma web para explorar NLAs sobre modelos abiertos, además de mecanismos programáticos que permiten automatizar estas operaciones. Asimismo, las implementaciones abiertas permiten ejecutar estos modelos sobre infraestructura propia [5], por lo que las capacidades necesarias para realizar análisis más amplios ya se encuentran disponibles.
Sin embargo, disponer de estas capacidades no resuelve por sí mismo la organización del proceso experimental. Cuando se analizan múltiples prompts, tokens o ejecuciones, es necesario coordinar de manera consistente la configuración utilizada, conservar los resultados intermedios, aplicar los mismos criterios de evaluación y mantener la trazabilidad entre cada decisión y su resultado. Sin esta organización, los análisis tienden a depender de procedimientos manuales, dificultando su comparación y reproducción posterior.
En ese escenario, resulta necesario definir de antemano la selección de prompts, las posiciones de tokens que serán observadas, la conservación de las verbalizaciones obtenidas, los criterios utilizados para evaluarlas y la forma en que los resultados serán agregados y comparados. A modo ilustrativo, un experimento con 100 prompts, 3 posiciones de análisis, 2 criterios de evaluación y 2 configuraciones multiplica rápidamente la cantidad de observaciones que deben procesarse bajo condiciones homogéneas, haciendo poco práctica una inspección manual. Mantener estas decisiones de forma consistente permite comparar y reproducir posteriormente las ejecuciones.
Esta necesidad encuentra un antecedente metodológico en las plataformas de evaluación de aplicaciones basadas en modelos de lenguaje, donde múltiples ejecuciones se organizan mediante datasets, evaluadores y métricas agregadas. Trasladar esta lógica al análisis de NLA permite pensar los experimentos no como una sucesión de inspecciones aisladas, sino como configuraciones reproducibles que pueden ejecutarse, evaluarse y compararse de manera sistemática.
La motivación central de NLASmith es facilitar experimentos sistemáticos y reproducibles sobre NLA mediante una infraestructura común. La plataforma no pretende determinar el significado definitivo de una activación ni reemplazar el juicio del investigador. Su propósito es ofrecer un mecanismo configurable para ejecutar, evaluar, registrar y comparar experimentos alrededor de las verbalizaciones, permitiendo analizar de forma sistemática los patrones que emergen entre tokens y ejecuciones.
3. Modelo conceptual de NLASmith
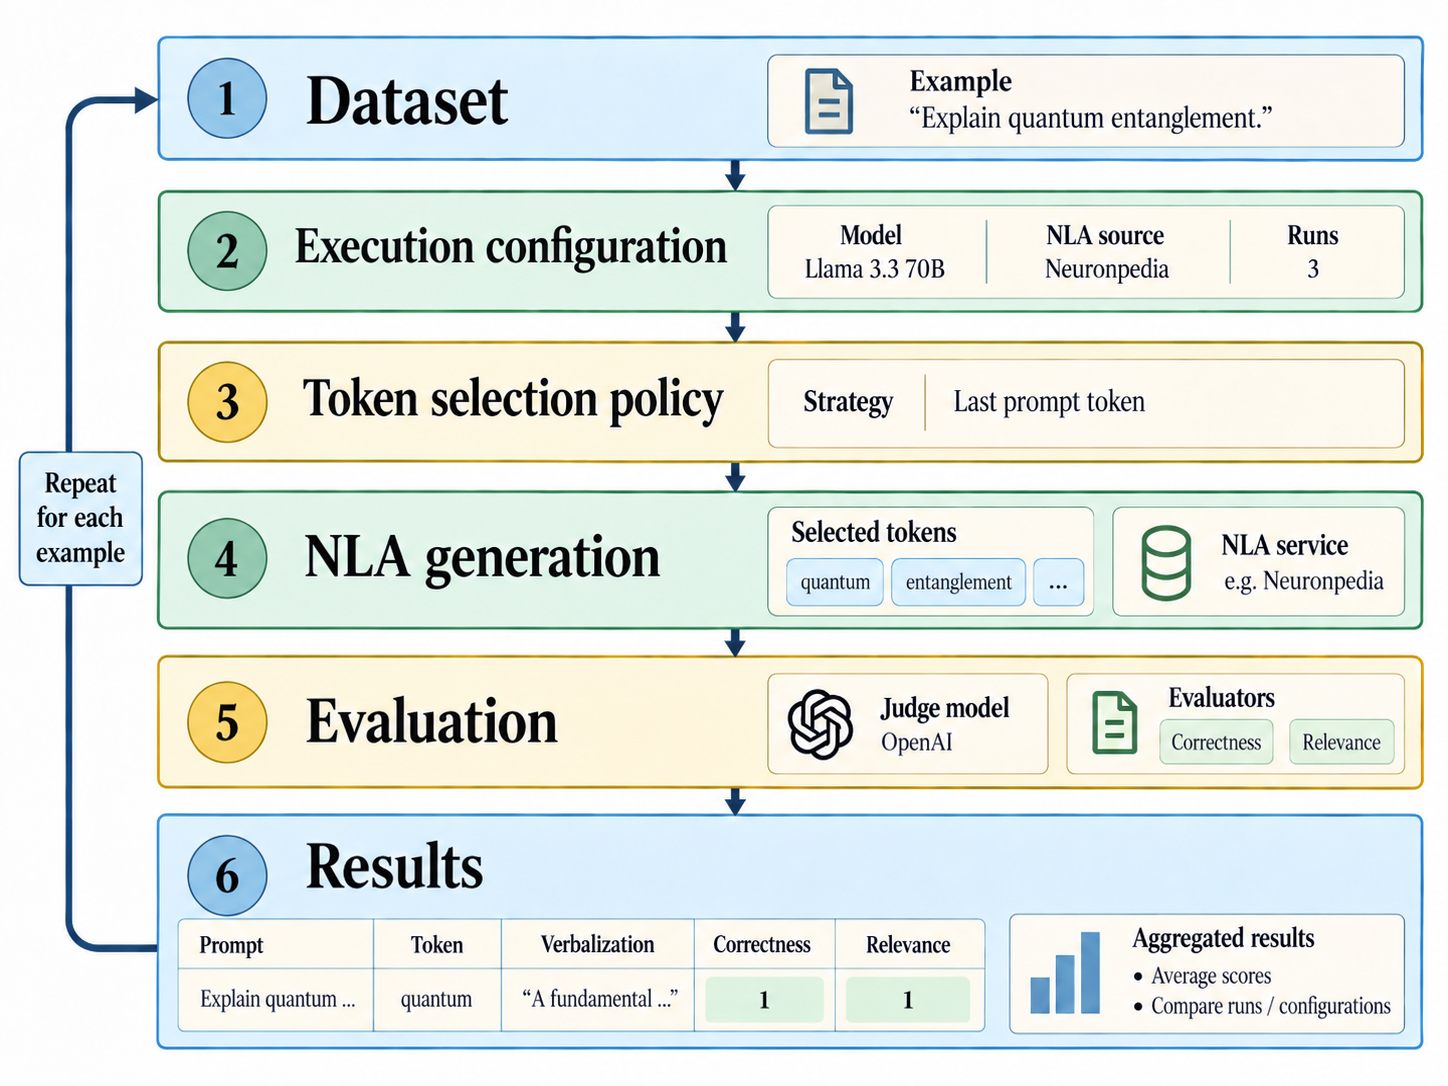
NLASmith organiza el experimento alrededor de cinco elementos principales: el dataset, la configuración de ejecución, la política de selección de tokens, los evaluadores y los resultados. Cada ejemplo del dataset se ejecuta bajo una configuración fija, las posiciones seleccionadas se envían al servicio de NLA y las verbalizaciones obtenidas son evaluadas según criterios definidos previamente. Finalmente, los resultados individuales se agregan para facilitar su análisis y comparación. Estos elementos conforman una unidad experimental reproducible, en la que quedan explícitamente definidas tanto las condiciones de ejecución como los criterios utilizados para interpretar y comparar las explicaciones NLA.
3.1. Definición de un experimento
Un experimento vincula un dataset de prompts con una fuente NLA, una política de selección de tokens y uno o más evaluadores. Esta definición debe persistir y poder ejecutarse nuevamente sin reconstruir manualmente cada paso. Para cada ejemplo se conservan, como mínimo, el prompt, la respuesta del modelo, las posiciones analizadas, las verbalizaciones obtenidas y el feedback generado por los evaluadores.
3.2. Política de selección de tokens
La posición observada forma parte de la definición experimental y no debería decidirse después de inspeccionar cada respuesta. NLASmith permite expresar reglas relativas, como el último token de contenido del usuario, el primer token del asistente o una ventana de posiciones alrededor de un límite conversacional. Mantener esta política constante permite comparar observaciones bajo un criterio homogéneo.
3.3. Evaluadores configurables
El framework separa la obtención del NLA de su evaluación. Un evaluador utiliza un LLM-as-a-judge con una rúbrica definida por el investigador. El formato de salida puede ser booleano, numérico o categórico. De este modo, el mismo mecanismo puede utilizarse para estudiar fenómenos diferentes sin modificar la lógica central de la plataforma.
Esta separación es relevante porque el evaluador automático no se considera una fuente de verdad sobre la activación, sino un instrumento de medición configurable. La rúbrica, el modelo utilizado como juez y la salida producida deben conservarse junto con la ejecución para que los resultados puedan auditarse, compararse y reproducirse.
3.4. Métricas y reproducibilidad
A partir del feedback producido para cada ejemplo, NLASmith calcula métricas agregadas como tasa de presencia, score medio, distribución por categoría y resultados segmentados por posición de token o subconjunto del dataset. Estas métricas pueden analizarse junto con las métricas de reconstrucción provistas por el propio NLA para obtener una visión más completa de los resultados. En conjunto, permiten pasar de observaciones individuales a patrones cuantificables y comparar ejecuciones realizadas bajo distintas configuraciones.
4. Arquitectura y componentes
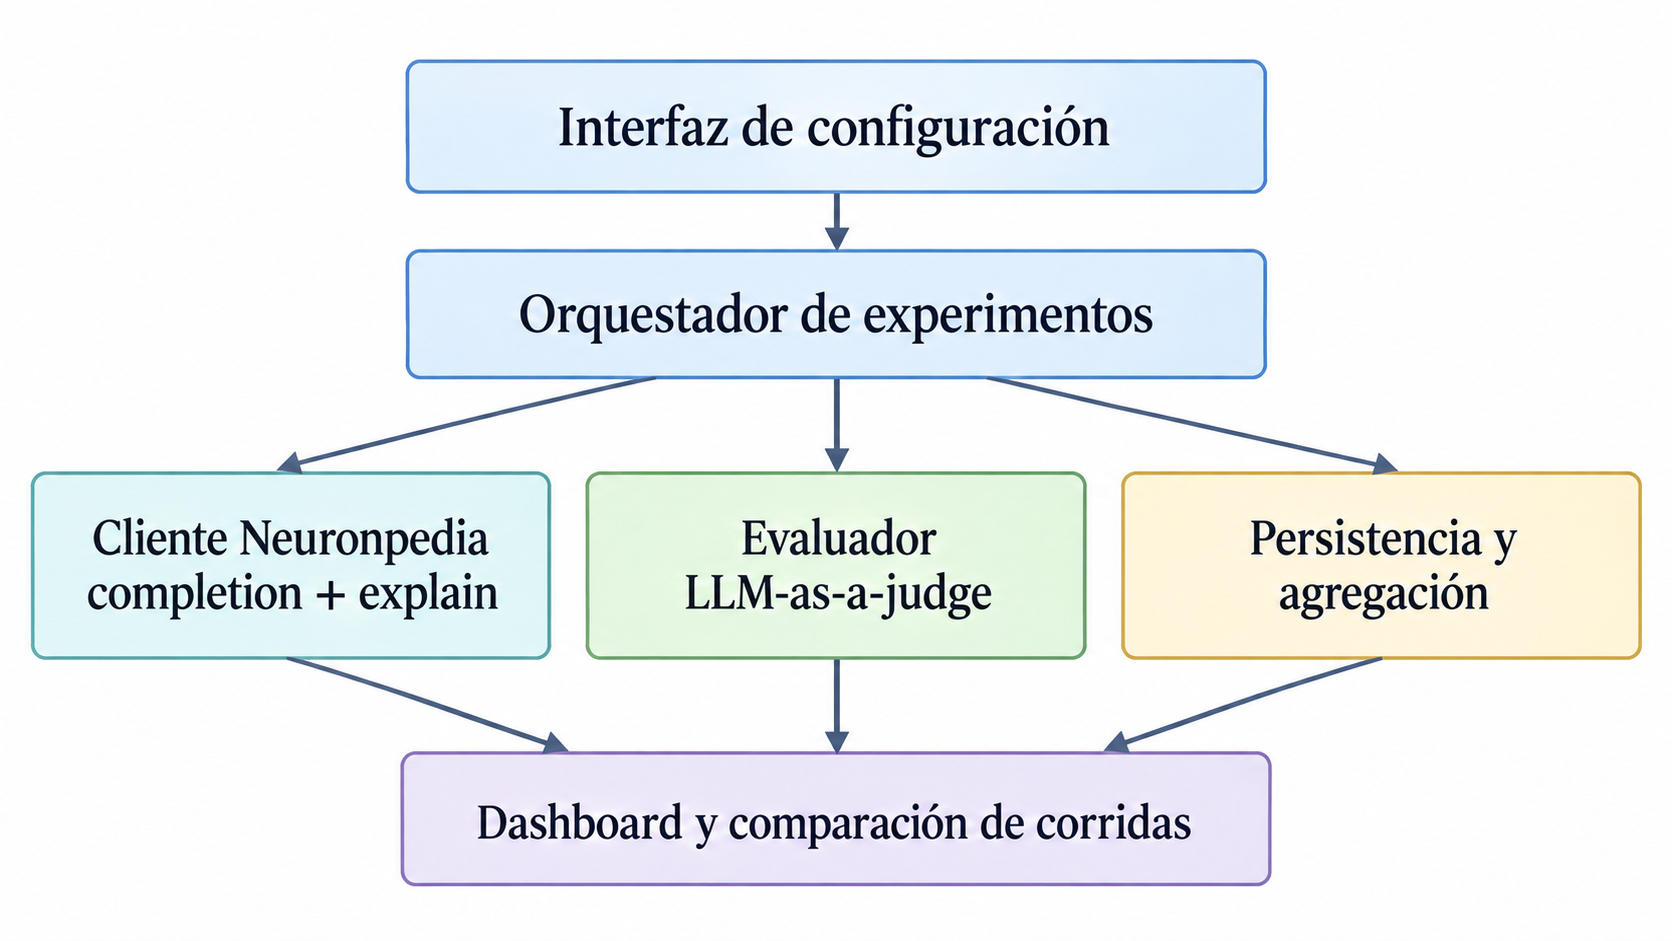
La arquitectura de NLASmith separa las responsabilidades de configuración, ejecución, acceso a NLA, evaluación, persistencia y visualización. El sistema no implementa ni entrena los autoencoders. Utiliza los NLA disponibles a través de Neuronpedia y coordina las operaciones necesarias para transformar un dataset en un conjunto trazable de observaciones y métricas.
4.1. Interfaz de configuración
La interfaz concentra los elementos que definen el experimento, incluidos el dataset, la fuente NLA, la política de tokens, el número de ejecuciones y los evaluadores. El objetivo es que estas decisiones queden establecidas antes de iniciar el proceso. La misma interfaz permite revisar experimentos previos y reutilizar configuraciones para favorecer comparaciones consistentes.
4.2. Orquestador de experimentos
El orquestador coordina el ciclo de cada ejemplo. Primero solicita la generación del modelo, luego resuelve las posiciones indicadas por la política de tokens y recupera las verbalizaciones correspondientes. Finalmente, envía los artefactos a los evaluadores configurados y persiste tanto los resultados finales como la información intermedia.
4.3. Integración con Neuronpedia
Neuronpedia [6] concentra la infraestructura de inferencia utilizada por NLASmith, alojando tanto los modelos de lenguaje empleados para generar las completions como los modelos NLA responsables de producir las verbalizaciones. NLASmith encapsula esta interacción en un módulo de integración que gestiona las consultas necesarias y transforma las respuestas obtenidas a un esquema interno común, permitiendo que el resto de los componentes trabajen de manera uniforme sobre los resultados generados por la plataforma.
4.4. Capa de evaluación
La capa de evaluación recibe, para cada ejemplo, las variables relevantes del experimento, incluyendo el prompt, la respuesta generada, el token observado, su posición y la verbalización NLA. El mecanismo de evaluación es LLM-as-a-judge, mediante el cual el investigador define una rúbrica en lenguaje natural que se aplica de forma sistemática sobre las verbalizaciones obtenidas.
NLASmith permite configurar el modelo utilizado como evaluador y el tipo de salida esperada, que puede ser booleana, numérica o categórica, con una justificación opcional. Los resultados se almacenan junto con cada ejecución para permitir su agregación y comparación entre experimentos. El modelo evaluador, la rúbrica y el esquema de salida forman parte de la configuración experimental, favoreciendo la reproducibilidad del análisis.
4.5. Persistencia, agregación y visualización
Cada ejecución experimental se almacena como una unidad identificable. Por citar algunas, la capa de persistencia conserva su configuración y los resultados, la capa de agregación calcula métricas a partir de los resultados producidos por los evaluadores y el dashboard presenta tablas y gráficos que permiten inspeccionar casos individuales sin perder la perspectiva global del experimento.
5. Funcionalidades e implementación
NLASmith se implementa como una plataforma web centrada en el ciclo experimental. La primera versión prioriza las capacidades necesarias para transformar una inspección manual en un proceso reproducible.
5.1. Gestión de datasets
El investigador puede crear un dataset de prompts, identificar cada ejemplo y, cuando resulte útil, asociar metadatos o una referencia esperada. El dataset funciona como unidad de comparación. De este modo, dos ejecuciones sobre el mismo conjunto pueden compararse entre prompts determinados como mediante métricas agregadas sobre el dataset completo.
5.2. Configuración de evaluadores
Los evaluadores se definen mediante una rúbrica en lenguaje natural, un modelo juez y un esquema de salida. La rúbrica establece el criterio aplicado y el esquema determina si el feedback será booleano, numérico o categórico. Este mecanismo permite detectar temáticas, asignar puntajes o clasificar verbalizaciones según categorías definidas por el investigador, adaptando NLASmith a distintas preguntas de investigación sin modificar la lógica del framework.
5.4. Resultados y comparación
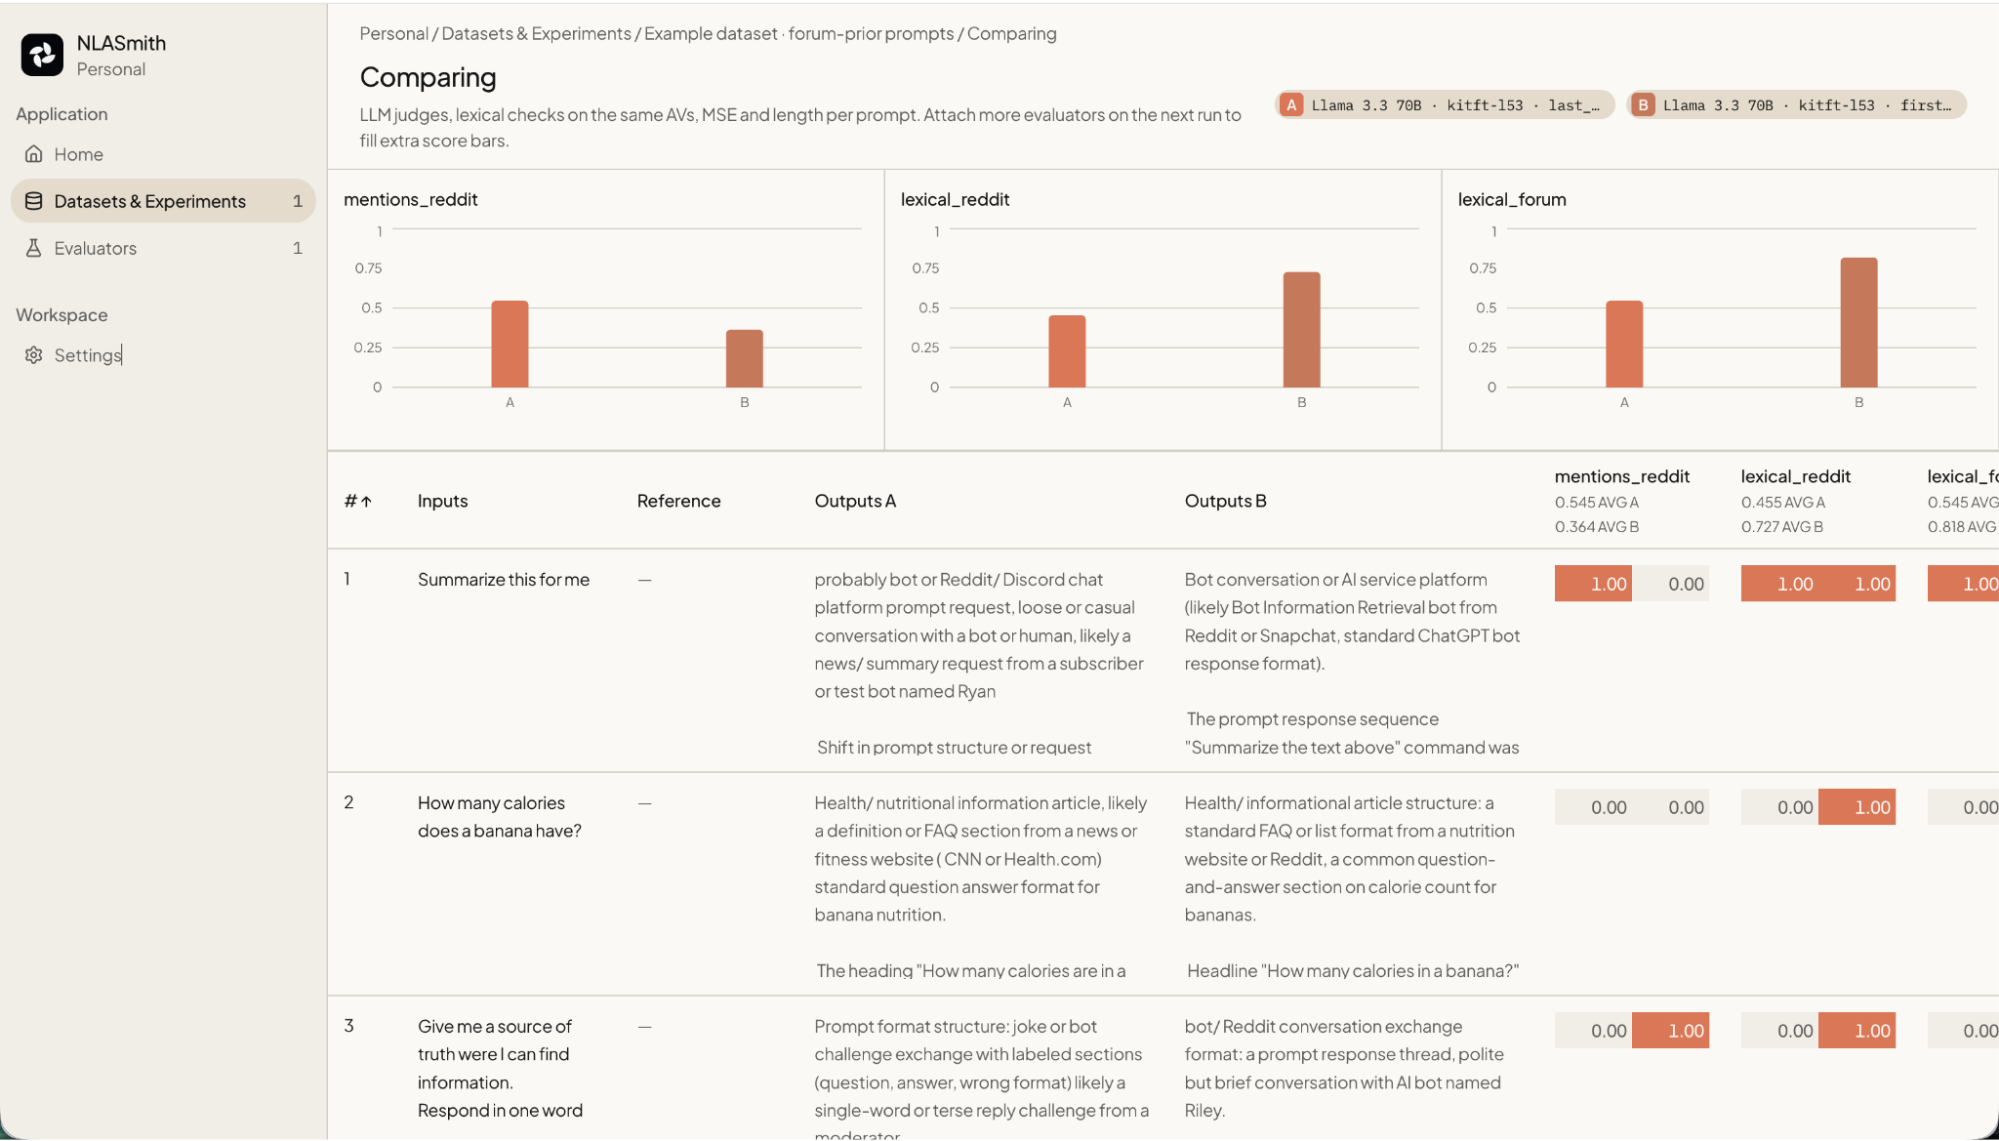
La vista de resultados combina dos niveles de análisis. El nivel individual presenta el prompt, la respuesta generada, el token, la verbalización y el feedback. El nivel agregado resume las métricas por evaluador y permite segmentarlas según la posición o la configuración utilizada. Cuando existen ejecuciones comparables, la plataforma presenta sus resultados de manera conjunta para facilitar el contraste.
5.5. Prototipo funcional
Como demostración técnica inicial, se implementó un prototipo funcional de NLASmith que integra las principales etapas del flujo experimental. La versión actual permite configurar experimentos, trabajar con datasets de prompts, definir evaluadores, ejecutar consultas y presentar resultados individuales y agregados dentro de una misma interfaz.
Esta implementación constituye una base operativa para validar las decisiones de diseño y obtener retroalimentación de potenciales usuarios. El código fuente se encuentra disponible en GitHub, mientras que el prototipo funcional puede consultarse en nlasmith.com.
6. Limitaciones
NLASmith hereda las limitaciones de los instrumentos y servicios sobre los que opera. Las verbalizaciones producidas por los NLA pueden contener afirmaciones que no reflejan con precisión la información contenida en la activación, por lo que deben analizarse con cautela y principalmente a partir de patrones que emergen entre múltiples observaciones [3]. Del mismo modo, las evaluaciones mediante LLM-as-a-judge pueden verse afectadas por la rúbrica, el modelo seleccionado y el contexto utilizado, por lo que sus resultados deben considerarse mediciones sujetas a validación. Adicionalmente, la implementación actual de NLASmith depende de la infraestructura provista por Neuronpedia, lo que restringe su ejecución a los modelos de inferencia y NLA alojados por la plataforma y a los límites de uso establecidos por su API.
7. Conclusión y trabajos futuros
Este trabajo presentó NLASmith, un framework para la experimentación con NLA. La herramienta transforma la inspección aislada de verbalizaciones provistas por los NLA en una experimentación reproducible, trazable y comparable. Establece una base común para estudiar patrones entre múltiples ejecuciones bajo criterios explícitos.
El aporte de NLASmith es proporcionar una infraestructura experimental que articula capacidades existentes para facilitar la evaluación sistemática de Natural Language Autoencoders. Su contribución se centra en organizar la exploración de activaciones dentro de un flujo reproducible y comparable, conservando las configuraciones, criterios de evaluación y resultados necesarios para repetir y contrastar los análisis.
Como líneas de trabajo futuro se plantea avanzar en la validación empírica de NLASmith mediante estudios experimentales. Esta instancia buscará analizar el impacto de la plataforma sobre la ejecución y el análisis de experimentos, con foco en la efectividad del proceso, así como la correspondencia entre los resultados agregados por NLASmith y las conclusiones obtenidas a partir de una revisión manual de las corridas individuales.
También se prevé difundir el prototipo entre investigadores vinculados con interpretabilidad y NLA para obtener retroalimentación sobre su utilidad, configurabilidad y capacidad para adaptarse a preguntas de investigación diferentes. Estos resultados permitirán refinar tanto la plataforma como el protocolo experimental propuesto.
NLASmith representa un paso concreto hacia una infraestructura que facilite nuevas investigaciones con Natural Language Autoencoders. Al promover análisis más sistemáticos, reproducibles y comparables, la propuesta busca contribuir a una mejor comprensión del funcionamiento interno de los modelos de lenguaje de gran escala, entendiendo esta comprensión como una base relevante para avanzar hacia sistemas de inteligencia artificial más seguros y con resultados beneficiosos.
Referencias
- [1] Fraser-Taliente, Kantamneni, Ong et al., “Natural Language Autoencoders Produce Unsupervised Explanations of LLM Activations”, Transformer Circuits, 2026. transformer-circuits.pub/2026/nla
- [2] C. Olah, “Interpretability Dreams”, Transformer Circuits Thread, 2023. transformer-circuits.pub/2023/interpretability-dreams
- [3] LangChain, “LangSmith: evaluation and experiment tracking for LLM applications”. docs.smith.langchain.com
- [4] Langfuse, “LLM Evaluation Core Concepts”. langfuse.com/docs/evaluation/core-concepts
- [5] kitft, “natural_language_autoencoders”, GitHub. github.com/kitft/natural_language_autoencoders
- [6] Neuronpedia, “Natural Language Autoencoders: demo and API”, 2026. neuronpedia.org/nla